
Robots.txt: Što je, User-agent, Disallow i Allow
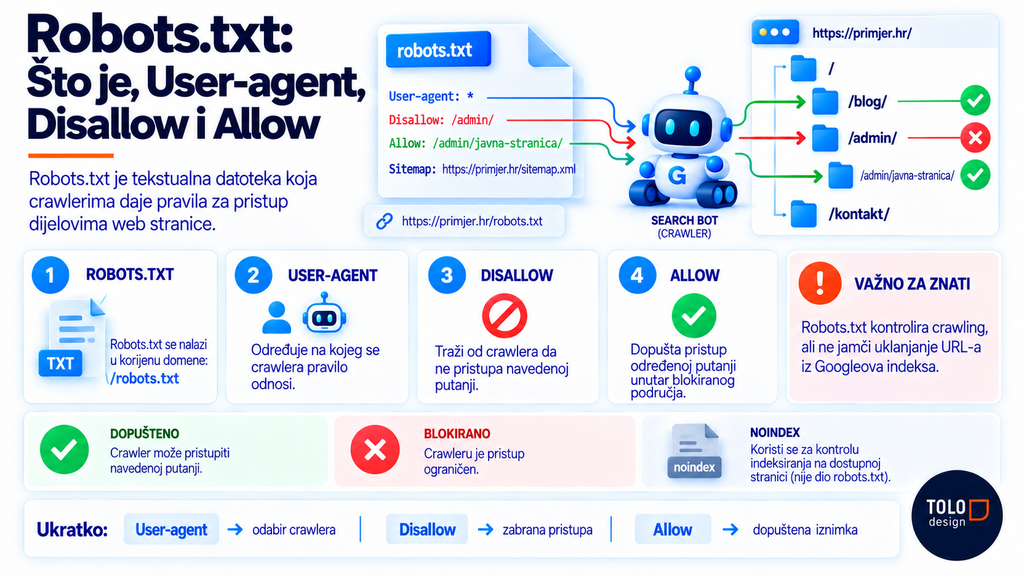
Robots.txt je tekstualna datoteka koja upravlja pristupom web crawlera URL-ovima web stranice. Datoteka se nalazi u korijenu domene i koristi direktive User-agent, Disallow i Allow. User-agent određuje crawler, primjerice Googlebot ili Bingbot. Disallow ograničava crawling određene URL putanje. Allow dopušta pristup određenoj putanji unutar šireg ograničenja.
Robots.txt usmjerava crawling prema važnim URL-ovima i ograničava pristup odabranim putanjama. Blokirane putanje mogu uključivati administrativne direktorije, interne rezultate pretraživanja i URL-ove s parametrima. Direktiva Sitemap može povezati robots.txt s XML sitemapom koji crawleru daje URL-ove za otkrivanje. Pravila se primjenjuju prema odnosu crawler → direktiva → URL putanja.
Robots.txt kontrolira crawling, ali ne jamči sprječavanje indeksiranja URL-a. Google može otkriti blokirani URL preko internih poveznica, vanjskih poveznica, sitemap datoteka ili ranije poznatih URL-ova. Noindex upravlja indeksiranjem, dok robots.txt upravlja pristupom crawlera. Google mora dohvatiti stranicu kako bi pročitao noindex direktivu.
Što je robots.txt?
Robots.txt je tekstualna datoteka koja crawlerima tražilica daje pravila o tome koje dijelove web stranice smiju ili ne smiju dohvaćati. Datoteka se nalazi u korijenu domene. Pravila povezuju crawler s putanjama, primjerice Googlebot → /admin/, /search/ ili /private/. Robots.txt upravlja crawlingom, ali sam po sebi ne jamči uklanjanje URL-a iz Googleova indeksa.
Robots.txt pravila određuju pristup crawlera određenim URL-ovima i direktorijima. Direktive, primjerice User-agent, Disallow i Allow, određuju crawler i dopuštenu ili zabranjenu putanju. User-agent identificira crawler. Disallow ograničava crawling određene putanje. Allow dopušta crawling određene putanje unutar šireg ograničenja.
Robots.txt može smanjiti nepotrebno crawlinganje URL-ova koji nisu važni za pretraživanje. Takvi URL-ovi uključuju interne rezultate pretrage, filtrirane URL-ove i administrativne putanje. Manje nepotrebnih zahtjeva usmjerava crawl resurse prema relevantnim stranicama, posebno ako web stranica sadrži velik broj URL-ova.
Robots.txt kontrolira crawling, dok indeksiranje predstavlja zaseban proces tražilice. Blokirani URL može ostati poznat Googleu preko poveznica ili drugih izvora. noindex upravlja zahtjevom za neindeksiranje kada crawler može dohvatiti stranicu i pročitati tu direktivu. Robots.txt zato nije zamjena za noindex.
Robots.txt je dio tehničkog SEO-a jer upravlja načinom na koji crawler pristupa strukturi web stranice. Ispravna pravila omogućuju pristup važnim resursima, primjerice HTML stranicama, CSS datotekama i JavaScript datotekama, dok ograničavaju odabrane putanje ako crawling tih URL-ova nema vrijednost za pretraživanje.
Čemu služi robots.txt?
Robots.txt služi za upravljanje pristupom web crawlera određenim dijelovima web stranice. Robots.txt daje crawlerima, poput Googlebota i Bingbota, pravila o URL-ovima koje mogu ili ne mogu dohvaćati. Datoteka se nalazi u korijenu domene, primjerice example.com/robots.txt.
Pristup web crawlera određuju direktive, poput User-agent, Disallow i Allow. User-agent određuje crawler na koji se pravilo odnosi. Disallow označava URL putanje koje crawler ne treba dohvaćati. Allow dopušta pristup određenoj URL putanji unutar šire blokirane putanje.
URL putanje kontroliraju crawling, a ne pouzdano indeksiranje. Blokirani URL može ostati ili postati indeksiran kada ga tražilica otkrije preko drugih izvora, poput internih poveznica, vanjskih poveznica i sitemap datoteka. Robots.txt zato nije metoda za uklanjanje URL-a iz indeksa.
Robots.txt može sadržavati lokaciju XML sitemap datoteke. Direktiva Sitemap crawleru daje URL sitemap datoteke, primjerice sitemap.xml. Sitemap zatim navodi URL-ove dostupne za otkrivanje i crawling.
Pravila robots.txt smanjuju nepotrebno dohvaćanje URL-ova, primjerice URL-ova filtera, parametara i internih rezultata pretraživanja. Takva kontrola usmjerava crawling prema URL-ovima koje vlasnik web stranice želi učiniti dostupnima crawlerima.
Kako radi robots.txt?
Robots.txt usmjerava dopuštene web crawlere prema dijelovima web stranice koje smiju ili ne smiju crawlati. Datoteka se nalazi u korijenu hosta, primjerice example.com/robots.txt. Pravila povezuju crawler s putanjama putem direktiva User-agent, Disallow i Allow.
- User-agent određuje crawler na koji se pravilo odnosi. Primjeri crawlera su Googlebot i Bingbot. Vrijednost * odnosi se na sve crawlere koji poštuju robots.txt.
- Disallow ograničava crawling određene URL putanje. URL putanje mogu biti /admin/, /search/ ili /private/. Crawler ne dohvaća odgovarajuću putanju kada se primjenjuje Disallow pravilo.
- Allow dopušta crawling određene URL putanje unutar ograničenog područja. URL putanja može ostati dostupna crawleru kada šire Disallow pravilo obuhvaća njezin nadređeni direktorij.
- Sitemap povezuje robots.txt sa XML sitemapom. XML sitemap navodi URL-ove, primjerice stranice, članke i kategorije, koje crawler može koristiti za otkrivanje sadržaja.
- robots.txt kontrolira crawling, a ne jamči uklanjanje URL-a iz Google indeksa. URL može ostati indeksiran ako ga Google otkrije preko poveznica ili drugih izvora, čak i kada robots.txt blokira njegovo crawling.
- Pravila ovise o crawleru i URL putanji. Crawler primjenjuje grupu pravila koja odgovara njegovom User-agent identitetu. Zatim uspoređuje traženu URL putanju s pravilima Allow i Disallow.
- robots.txt je javno dostupna datoteka. Lozinke, privatni dokumenti i povjerljivi URL-ovi ne štite se robots.txt pravilima. Pristup takvom sadržaju ograničava se autentifikacijom ili autorizacijom.
Provjera robots.txt datoteke
Unesite domenu ili URL web stranice. Klikom na gumb otvorit ćete njezinu datoteku robots.txt u novoj kartici.
Ako se nova kartica nije otvorila, kliknite poveznicu.
Ručni pregled datoteke. Alat otvara adresu robots.txt. Ne potvrđuje automatski postoji li datoteka niti provjerava ispravnost njezinih pravila.
Za korištenje alata omogućite JavaScript u pregledniku.
Zašto je robots.txt važan za SEO?
Robots.txt je važan za SEO jer upravlja pristupom crawlera određenim dijelovima web stranice i tako usmjerava crawl budget prema URL-ovima koje tražilica može obraditi. Robots.txt daje crawlerima, primjerice Googlebotu i Bingu, pravila Allow i Disallow za direktorije, datoteke i URL obrasce. Pravilna pravila smanjuju nepotrebno crawlanje URL-ova, primjerice internih rezultata pretraživanja, parametarskih URL-ova i administrativnih direktorija.
Crawl budget određuje koliko URL-ova crawler može i želi dohvatiti na web stranici tijekom određenog razdoblja. Crawl budget može se učinkovitije rasporediti kada robots.txt ograniči pristup URL-ovima bez SEO vrijednosti. Takva kontrola ostavlja više crawling resursa za važne URL-ove, primjerice stranice usluga, kategorije i članke.
Besplatna analiza web stranice
Započnite SEO optimizaciju svoje web stranice
SEO optimizacija počinje analizom sadržaja, tehničke
strukture i pozicija web stranice.
Pošaljite nam URL stranice. Dobit ćete pregled ključnih problema
i preporuku sljedećih koraka.
- Tehnički SEO pregled
- Analiza ključnih riječi
- Pregled sadržaja
- Odgovor u roku od 24 sata
Pravila pristupa utječu na dostupnost sadržaja crawleru, ali Disallow nije naredba za uklanjanje URL-a iz Googleova indeksa. Blokirani URL može ostati indeksiran ako ga Google otkrije preko poveznica ili drugih izvora. noindex ili drugi odgovarajući mehanizam koristi se kada je cilj spriječiti indeksiranje, dok robots.txt prvenstveno kontrolira crawling.
Robots.txt može utjecati na renderiranje stranice kada blokira resurse, primjerice CSS i JavaScript datoteke. Googlebot dobiva manje informacija o sadržaju i strukturi stranice kada resurs potreban za renderiranje nije dostupan. Pravila zato trebaju omogućiti pristup resursima koji Googleu pomažu obraditi važan sadržaj.
Lokacija XML sitemapa može se navesti u robots.txt datoteci pomoću direktive Sitemap. XML sitemap daje tražilici popis važnih URL-ova, dok robots.txt određuje područja dostupna crawleru. Ta dva signala zajedno pomažu crawleru pronaći i obraditi relevantne URL-ove.
Gdje se nalazi robots.txt datoteka?
Datoteka robots.txt nalazi se u korijenskom direktoriju domene i dostupna je na adresi https://domena.com/robots.txt. Korijenski direktorij predstavlja najvišu razinu web-stranice za određeni host. Datoteka vrijedi za taj host kada se nalazi upravo na toj lokaciji.
Lokacija robots.txt datoteke određuje njezinu primjenu. Primjeri lokacija uključuju https://example.com/robots.txt za glavnu domenu i https://shop.example.com/robots.txt za poddomenu. Lokacije poput https://example.com/blog/robots.txt nisu robots.txt datoteka za cijeli host.
Tražilice pronalaze robots.txt na standardnoj putanji /robots.txt. Googlebot i drugi web crawler-i dohvaćaju tu datoteku s korijena odgovarajućeg hosta. Pravila u datoteci zatim povezuju crawler s putanjama na koje se pravila odnose.
Kako napraviti robots.txt?
Robots.txt se napravi kao obična tekstualna datoteka koja pravilima User-agent, Disallow i Allow određuje koje URL putanje crawler može zatražiti. Datoteka se sprema pod nazivom robots.txt u korijenski direktorij domene. Adresa datoteke tada odgovara obrascu domena.com/robots.txt.
Odredi crawler
- User-agent određuje crawler na koji se pravilo odnosi.
- Googlebot označava Googleov crawler.
- * obuhvaća sve crawlere koji poštuju robots.txt.
- Pravilo povezuje crawler s dopuštenim ili blokiranim URL putanjama.
Odredi URL putanje
- Disallow ograničava crawling određene URL putanje.
- Allow dopušta crawling određene URL putanje unutar šireg ograničenja.
- URL putanje mogu predstavljati direktorije i stranice, primjerice /admin/, /private/ i /cart/.
- Prazna vrijednost Disallow ne blokira URL putanje.
Postavi robots.txt u korijen domene
- Robots.txt pripada korijenu hosta na koji se pravila odnose.
- Datoteka za example.com nalazi se na example.com/robots.txt.
- Datoteka postavljena u poddirektorij ne predstavlja robots.txt za cijeli host.
- HTTPS i drugi hostovi, primjerice poddomene, imaju vlastiti robots.txt kontekst.
Kako pravilno postaviti robots.txt?
Robots.txt se pravilno postavlja tako da pravilo poveže točan crawler s točnom URL putanjom bez blokiranja sadržaja koji crawler treba dohvatiti. Najjednostavnija konfiguracija dopušta crawling javnih stranica i ograničava samo putanje koje crawler nema razlog dohvaćati.
Grupiraj pravila prema crawleru
- User-agent grupa povezuje crawler s njegovim pravilima.
- Više pravila, primjerice Allow i Disallow, može pripadati istoj grupi.
- Posebna grupa može ciljati Googlebot kada Google treba drugačija pravila od drugih crawlera.
- Opća grupa koristi User-agent: * kada ista pravila vrijede za sve crawlere.
Blokiraj precizne putanje
- Disallow pravilo treba opisivati URL putanju koju želiš ograničiti.
- Blokirane putanje mogu biti tehnički direktoriji, primjerice /private/, /tmp/ i /staging/.
- Javne stranice ostaju dostupne crawleru kada ih pravila ne ograničavaju.
- Široko pravilo može blokirati važan sadržaj ako obuhvati više URL-ova od planiranog.
Poveži sitemap
- Sitemap direktiva može navesti lokaciju XML sitemapa.
- XML sitemap može sadržavati kanonske URL-ove, primjerice početnu stranicu, kategorije i članke.
- Sitemap i robots.txt imaju različite funkcije.
- Robots.txt upravlja crawlingom, dok sitemap crawleru daje URL-ove za otkrivanje.
Kako urediti robots.txt?
Robots.txt se uređuje promjenom postojećih User-agent, Disallow, Allow i Sitemap direktiva prema URL strukturi web stranice. Svaka promjena treba imati jasan odnos crawler → pravilo → URL putanja.
Provjeri postojeća pravila
- Postojeća pravila pokazuju koje crawlere i URL putanje robots.txt već obrađuje.
- Provjera otkriva blokirane direktorije, primjerice /admin/, /search/ i /private/.
- Posebnu pažnju traže pravila koja zahvaćaju velik broj javnih URL-ova.
- Promjena pravila ima smisla kada postojeće pravilo ne odgovara željenom crawlingu.
Promijeni samo potrebno pravilo
- Precizna izmjena smanjuje mogućnost slučajnog blokiranja drugih URL-ova.
- Disallow se mijenja kada crawler treba dobiti ili izgubiti pristup određenoj putanji.
- Allow se koristi kada uža putanja treba ostati dostupna unutar šire blokirane putanje.
- User-agent se mijenja kada pravilo treba vrijediti za drugi crawler.
Spremi datoteku na isto mjesto
- Uređeni robots.txt ostaje u korijenu istog hosta.
- Naziv datoteke ostaje robots.txt.
- Crawler čita nova pravila nakon ponovnog dohvaćanja datoteke.
- Staro pravilo može privremeno ostati relevantno dok crawler ponovno ne pročita robots.txt.
Kako provjeriti robots.txt?
Robots.txt se provjerava otvaranjem /robots.txt na domeni i analizom odnosa između crawlera, pravila i ciljane URL putanje. Provjera treba utvrditi postoji li datoteka, može li se dohvatiti i blokira li željeni URL.
Provjeri dostupnost datoteke
- URL robots.txt datoteke treba biti dostupan na korijenskoj adresi hosta.
- Preglednik može prikazati sadržaj datoteke kao običan tekst.
- Dostupna datoteka omogućuje pregled direktiva, primjerice User-agent, Disallow, Allow i Sitemap.
- Pogrešna lokacija znači da pravila ne predstavljaju robots.txt za taj host.
Provjeri crawler
- User-agent pokazuje kojem crawleru pripada grupa pravila.
- Googlebot može imati vlastitu grupu.
- Ostali crawleri mogu koristiti zasebne grupe.
- User-agent: * predstavlja opću grupu za crawlere bez specifičnijeg podudaranja prema pravilima koja primjenjuju.
Provjeri ciljanu URL putanju
- Ciljani URL treba usporediti s relevantnim Allow i Disallow pravilima.
- Provjera određuje dopušta li robots.txt crawling konkretne stranice.
- URL-ovi, primjerice /blog/, /shop/product/ i /private/page/, mogu imati različit rezultat.
- Rezultat ovisi o pravilu koje se primjenjuje na odabrani crawler i URL putanju.
Kako testirati robots.txt?
Robots.txt se testira provjerom konkretnog crawlera protiv konkretnog URL-a kako bi se utvrdilo daje li skup pravila rezultat allowed ili blocked. Test treba koristiti stvarni URL jer samo čitanje datoteke ne pokazuje uvijek učinak kombiniranih pravila.
Odaberi crawler
- Crawler je prvi parametar testa.
- Test može koristiti Googlebot ili drugi definirani user-agent.
- Različiti crawleri mogu dobiti različite rezultate za isti URL.
- Rezultat ostaje vezan uz odabrani user-agent.
Odaberi konkretan URL
- URL je drugi parametar testa.
- Testiraj važne URL-ove, primjerice početnu stranicu, kategoriju i članak.
- Testiraj blokirane URL-ove, primjerice administracijske ili interne putanje.
- Svaki URL daje zaseban rezultat prema pravilima koja ga obuhvaćaju.
Utvrdi rezultat pravila
- Test povezuje User-agent + URL putanju + Allow/Disallow pravilo.
- Rezultat allowed znači da robots.txt ne zabranjuje crawleru dohvaćanje testiranog URL-a.
- Rezultat blocked znači da primjenjivo robots.txt pravilo ograničava crawling testiranog URL-a.
- Pravilo treba izmijeniti kada rezultat nije jednak namjeravanom ponašanju crawlera.
Koje naredbe koristi robots.txt?
robots.txt koristi direktive User-agent, Disallow, Allow i Sitemap za određivanje pravila pristupa crawlerima i navođenje lokacije XML sitemapa. User-agent određuje crawler. Disallow određuje putanju kojoj crawler ne pristupa. Allow određuje dopuštenu putanju unutar ograničenog područja. Sitemap navodi URL XML sitemapa.
Kako direktive rade zajedno?
Direktive robots.txt stvaraju pravila između crawlera i URL putanja web stranice. Pravila, primjerice zabrana cijelog direktorija ili dopuštanje određene podmape, povezuju User-agent s Disallow i Allow vrijednostima. Sitemap nije pravilo pristupa. Sitemap crawleru daje lokaciju XML sitemapa.
Što znači User-agent u robots.txt?
User-agent određuje kojem web crawleru pripadaju pravila navedena ispod te direktive u robots.txt datoteci. Vrijednost može predstavljati određenog crawlera ili sve crawlere. Zvjezdica * predstavlja crawlere na koje se odnosi zajednička grupa pravila.
Kako User-agent određuje primjenu pravila?
User-agent povezuje crawler s pravilima pristupa URL-ovima. Pravila pristupa, primjerice Disallow i Allow, primjenjuju se na crawler definiran u pripadajućoj User-agent grupi. Posebna grupa može sadržavati druga pravila kada određeni crawler zahtijeva drukčiji pristup.
Što znači Disallow u robots.txt?
Disallow određuje URL putanju koju crawler definiran direktivom User-agent ne smije crawlati. Vrijednost može označavati direktorij, URL putanju ili skup URL-ova koji odgovaraju podržanom obrascu. Disallow kontrolira crawling. Disallow sam po sebi nije naredba za uklanjanje URL-a iz indeksa.
Što Disallow ograničava?
Disallow ograničava pristup crawlera određenim putanjama web stranice. Putanje, primjerice /admin/, /private/ i /test/, mogu predstavljati područja koja crawler ne treba dohvaćati. Ograničenje vrijedi za odgovarajući User-agent kada se Disallow nalazi u njegovoj grupi pravila.
Što znači Allow u robots.txt?
Allow određuje URL putanju kojoj crawler smije pristupiti unutar područja obuhvaćenog pravilom Disallow. Direktiva preciznije određuje dopuštenu putanju kada šire robots.txt pravilo ograničava crawling.
Kada se koristi Allow?
Allow stvara iznimku unutar šire zabrane pristupa. Iznimke, primjerice dopuštena podmapa ili određena datoteka unutar blokiranog direktorija, crawleru daju preciznije pravilo za URL. Allow ima smisla kada Disallow obuhvaća širu putanju od sadržaja koji stvarno želite blokirati.
Što znači Sitemap u robots.txt?
Sitemap u robots.txt navodi apsolutni URL XML sitemapa web stranice. Ta direktiva crawleru pokazuje gdje se nalazi datoteka koja sadrži URL-ove dostupne za otkrivanje i crawling.
Koju vezu Sitemap stvara?
Sitemap povezuje robots.txt s XML sitemapom web stranice. XML sitemap može sadržavati URL-ove, primjerice stranice, članke i kategorije, koje vlasnik web stranice želi izložiti crawlerima. Sitemap direktiva ne dopušta niti zabranjuje crawling tih URL-ova.
Kako dodati sitemap u robots.txt?
Sitemap se dodaje navođenjem direktive Sitemap i punog URL-a XML sitemap datoteke u robots.txt datoteci. Vrijednost sadrži protokol, domenu i putanju sitemapa. Primjer vrijednosti je https://example.com/sitemap.xml.
Gdje navesti sitemap?
Sitemap direktiva može se navesti kao zasebna linija u robots.txt datoteci. Više sitemapova, primjerice sitemap stranica, članaka i proizvoda, može se navesti zasebnim Sitemap direktivama. Svaka direktiva tada identificira jednu lokaciju XML sitemapa.
Treba li sitemap biti naveden u robots.txt?
Sitemap ne mora biti naveden u robots.txt, ali njegovo navođenje crawlerima daje izravnu lokaciju XML sitemapa. XML sitemap može biti otkriven drugim putem. Sitemap direktiva stvara jasnu vezu između robots.txt datoteke i lokacije sitemapa.
Kada je navođenje sitemapa korisno?
Navođenje sitemapa smanjuje broj koraka potrebnih crawleru za pronalazak XML sitemapa. Prednost postoji kod sitemapova, primjerice glavnog sitemap indeksa ili više zasebnih sitemap datoteka, jer robots.txt izravno navodi njihove URL-ove. Više Sitemap direktiva može se koristiti kada web stranica koristi više sitemap lokacija.
Kako blokirati određene botove u robots.txt?
Odgovor
Određeni bot blokira se u robots.txt datoteci povezivanjem njegova User-agent identifikatora s pravilom Disallow. User-agent određuje crawler na koji se pravilo odnosi. Disallow određuje URL putanju kojoj taj crawler ne pristupa.
Blokirani bot ne dohvaća navedene URL-ove kada poštuje robots.txt pravila. Botovi, primjerice Googlebot, Bingbot i GPTBot, koriste vlastite User-agent identifikatore. Blokiranje jednog bota ne blokira druge botove, ako njihovi identifikatori nisu obuhvaćeni istim pravilom.
Kako dopustiti Googlebotu pristup stranici?
Googlebotu se pristup stranici dopušta kada robots.txt ne sadrži Disallow pravilo koje obuhvaća URL te stranice. Posebno Allow pravilo može označiti dopuštenu URL putanju unutar šire blokirane putanje.
Googlebot pristupa dopuštenom URL-u i može dohvatiti njegov sadržaj. Dohvaćanje sadržaja omogućuje Googleu obradu elemenata, primjerice teksta, poveznica, meta robots oznake i strukturiranih podataka, ako Googlebot može pristupiti tim resursima.
Kako zabraniti Googlebotu pristup direktoriju?
Googlebotu se pristup direktoriju zabranjuje pravilom Disallow za putanju tog direktorija unutar User-agent: Googlebot grupe. Putanja direktorija određuje skup URL-ova koje Googlebot ne smije dohvaćati prema robots.txt pravilima.
Zabrana direktorija odnosi se na URL-ove ispod navedene putanje, primjerice /admin/, /private/ i njihove podstranice kada su te putanje navedene kao Disallow. Googlebot tada ne dohvaća blokirane URL-ove, ali URL može ostati poznat Googleu iz drugih izvora.
Može li robots.txt spriječiti indeksiranje?
Robots.txt ne jamči sprječavanje indeksiranja jer prvenstveno kontrolira crawling, odnosno pristup crawlera URL-u. Google može znati za blokirani URL preko poveznica, sitemap datoteka ili prethodnog crawlanja iako sadržaj trenutačno ne može dohvatiti.
Sprječavanje indeksiranja zahtijeva direktivu namijenjenu indeksiranju, primjerice noindex meta robots oznaku ili X-Robots-Tag: noindex. Google mora moći dohvatiti URL kako bi pročitao noindex, ako se ta direktiva nalazi na blokiranoj stranici.
Blokira li robots.txt indeksiranje stranice?
Ne. Robots.txt blokira crawling stranice, ali sam po sebi ne predstavlja pouzdanu zabranu indeksiranja URL-a. Blokirana stranica može biti prikazana u Googleovu indeksu kao URL bez sadržaja koji Google nije mogao dohvatiti.
Indeksiranje i crawling predstavljaju različite procese. Crawling dohvaća URL i njegov sadržaj. Indeksiranje obrađuje informacije o URL-u za moguću pohranu u Googleovu indeksu. Robots.txt izravno upravlja prvim procesom, a ne drugim.
Koja je razlika između robots.txt i noindex oznake?
Robots.txt kontrolira pristup crawlera URL-u, dok noindex kontrolira može li dohvaćena stranica ostati u indeksu. Robots.txt koristi pravila, primjerice User-agent, Disallow i Allow. Noindex se koristi kao meta robots direktiva ili HTTP X-Robots-Tag zaglavlje.
Noindex mora biti dostupan crawleru da bi ga tražilica mogla obraditi. Googlebot možda neće vidjeti noindex oznaku ako robots.txt istodobno blokira crawling istog URL-a. Zato blokiranje crawlanja i uklanjanje iz indeksa nisu ista radnja.
Koja je razlika između robots.txt i meta robots oznake?
Robots.txt daje crawlerima pravila za dohvaćanje URL-ova, dok meta robots oznaka daje tražilicama direktive za obradu dohvaćene HTML stranice. Meta robots direktive, primjerice noindex i nofollow, određuju način obrade stranice nakon pristupa njezinu HTML-u.
Meta robots oznaka nalazi se unutar HTML dokumenta i zato zahtijeva pristup dokumentu. Robots.txt nalazi se na razini web sjedišta i provjerava se prije dohvaćanja blokiranih URL-ova. Meta robots direktiva ne može biti pročitana kada crawler zbog robots.txt pravila ne dohvaća stranicu.
Može li Google indeksirati stranicu blokiranu u robots.txt?
Da. Google može indeksirati URL blokiran u robots.txt datoteci bez crawlanja njegova sadržaja. Google može otkriti blokirani URL preko internih poveznica, vanjskih poveznica, sitemap datoteka ili ranije poznatih URL-ova.
Blokirani URL može zato postojati u Googleovu indeksu iako Google nema pristup aktualnom sadržaju stranice. Noindex daje jasnu direktivu protiv indeksiranja, ali Google mora dohvatiti stranicu kako bi pročitao tu direktivu.
Započnite SEO optimizaciju svoje web stranice
SEO optimizacija počinje analizom sadržaja, tehničke strukture i pozicija web stranice. Pošaljite nam URL stranice. Dobit ćete pregled ključnih problema i preporuku sljedećih koraka.
- Tehnički SEO pregled
- Analiza ključnih riječi
- Pregled sadržaja
- Odgovor u roku od 24 sata
