
Indeksiranje web stranice: kako Google otkriva, crawla i indeksira URL
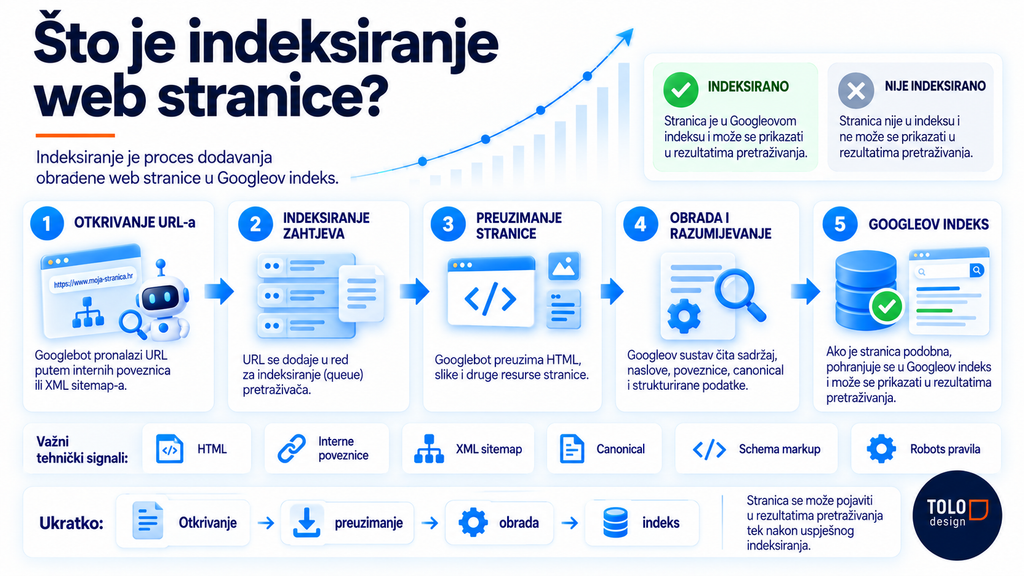
Indeksiranje web stranice je proces kojim Google obrađuje sadržaj URL-a i pohranjuje informacije o stranici u svoj indeks. Proces počinje otkrivanjem URL-a putem izvora, primjerice internih poveznica, vanjskih poveznica i XML sitemapa. Googlebot zatim crawla URL, Google renderira sadržaj, analizira tekst, slike, poveznice i strukturirane podatke te određuje kanonski URL. Indeksirani URL može postati kandidat za prikazivanje u rezultatima pretraživanja, ali indeksiranje samo po sebi ne jamči rangiranje.
Indeksiranje ovisi o dostupnosti URL-a, tehničkim signalima i kvaliteti sadržaja. Probleme mogu uzrokovati noindex, robots.txt, HTTP pogreške, pogrešan canonical, duplicirani sadržaj i slaba interna povezanost. Indeksiranje se može ubrzati slanjem URL-a kroz Google Search Console, dodavanjem URL-a u XML sitemap, povezivanjem relevantnim internim poveznicama i uklanjanjem crawl ili render problema. Jedinstven i sadržajno potpun URL daje Googleu jasnije informacije o glavnom entitetu, atributima i odnosima stranice.
Neindeksirani URL prvo treba dijagnosticirati prema njegovu konkretnom statusu u Google Search Consoleu. „Crawled – currently not indexed” znači da je Google crawlao URL, ali ga nije uključio u indeks, pa se provjeravaju sadržaj, jedinstvenost, canonical, interne poveznice i tehnički signali. „Discovered – currently not indexed” znači da Google poznaje URL, ali ga još nije crawlao, pa su važni crawl prioritet, interna povezanost i tehnička dostupnost. Relevantne interne poveznice, kratka dubina klika, indeksabilni URL-ovi i sadržaj s jasnom informacijskom vrijednošću povećavaju mogućnost pravilnog otkrivanja, obrade i indeksiranja.
Što je indeksiranje web stranice?
Indeksiranje web stranice je proces kojim tražilica obrađuje sadržaj web stranice i pohranjuje informacije o njezinim URL-ovima u svoj indeks. Indeksiranje omogućuje tražilici povezivanje web stranice s relevantnim upitima. URL može biti prikazan u rezultatima pretraživanja nakon indeksiranja, kada odgovara upitu i ispunjava uvjete tražilice.
Tražilica obrađuje sadržaj web stranice nakon što otkrije i dohvati URL. Sadržaj web stranice uključuje elemente, kao što su tekst, naslovi, slike, poveznice i strukturirani podaci. Sustav analizira te elemente kako bi odredio temu, entitete, atribute i odnose predstavljene na stranici.
Analizirani elementi web stranice daju informacije o značenju URL-a. Elementi web stranice, kao što su H1 naslov, podnaslovi, glavni tekst, anchor tekst i strukturirani podaci, opisuju entitete i njihove atribute. Tražilica povezuje te informacije s pojmovima i upitima koji imaju blisko značenje.
Informacije o URL-u ulaze u indeks kada sustav odluči obraditi i pohraniti URL. Indeks sadrži podatke koje tražilica koristi za pronalaženje relevantnih dokumenata tijekom pretraživanja. Indeksiranje ne jamči visoku poziciju jer rangiranje određuje položaj indeksiranog URL-a za određeni upit.
Indeksiranje se razlikuje od indeksabilnosti. Indeksabilnost opisuje mogućnost URL-a da bude indeksiran. Indeksiranje opisuje stvarnu obradu i uključivanje informacija o URL-u u indeks. URL može biti indeksabilan, ali još uvijek neindeksiran, kada ga tražilica nije obradila ili ga nije odabrala za indeksiranje.
Indeksiranje se razlikuje i od otkrivanja URL-a. Otkrivanje znači da je tražilica pronašla URL preko izvora, kao što su interne poveznice, vanjske poveznice i XML sitemap. Pronalaženje URL-a prethodi obradi sadržaja, dok indeksiranje predstavlja kasniju fazu u kojoj se informacije o URL-u mogu pohraniti u indeks.
Proces otkrivanja, dohvaćanja i indeksiranja URL-a povezan je s tehničkom SEO optimizacijom. Tehnička SEO optimizacija poboljšava tehničke uvjete koji tražilici omogućuju pristup i obradu URL-ova. Ti uvjeti uključuju interne poveznice, XML sitemap, robots.txt, canonical oznake, HTTP statusne kodove i meta robots direktive. Ispravna tehnička SEO optimizacija smanjuje prepreke koje mogu otežati otkrivanje, indeksabilnost i indeksiranje važnih URL-ova.
Kako funkcionira indeksiranje web stranice?
Indeksiranje web stranice funkcionira tako da Google obrađuje pronađenu web stranicu, analizira njezin sadržaj i sprema podatke o stranici u Googleov indeks. Googlebot prvo dohvaća URL. Google zatim renderira stranicu, obrađuje tekst i druge resurse te utvrđuje kanonski URL. Indeksiranje omogućuje da indeksirana stranica bude kandidat za prikaz u rezultatima pretraživanja kada odgovara relevantnom upitu.
- Googlebot dohvaća URL. Googlebot pristupa URL-u koji je Google otkrio putem poveznica, XML sitemap datoteke ili drugih poznatih URL-ova. Dohvaćanje daje Googleu HTML i dostupne resurse stranice.
- Google renderira stranicu. Renderiranje obrađuje HTML i resurse, primjerice CSS i JavaScript. Google tako dobiva sadržaj koji može analizirati nakon učitavanja stranice.
- Google analizira sadržaj. Analiza sadržaja prepoznaje elemente, primjerice naslov stranice, glavni tekst, slike, poveznice i strukturirane podatke. Ti elementi daju informacije o temi, entitetima, atributima i odnosima na stranici.
- Google određuje kanonski URL. Kanonizacija odabire reprezentativni URL među sličnim ili dupliciranim URL-ovima. Google može indeksirati odabrani kanonski URL umjesto alternativne verzije iste stranice.
- Google sprema podatke u indeks. Googleov indeks organizira informacije o obrađenim web stranicama. Indeks može sadržavati podatke o sadržaju, kanonskom URL-u i drugim signalima potrebnim za dohvaćanje dokumenta tijekom pretraživanja.
- Indeksirana stranica postaje dostupna sustavu za dohvaćanje. Sustav za dohvaćanje traži relevantne dokumente iz indeksa kada korisnik pošalje upit. Indeksiranje samo po sebi ne jamči prikaz ni određenu poziciju.
Zašto Google ne indeksira moju web stranicu?
Google ne indeksira web stranicu kada Googlebot ne može pronaći, pristupiti, obraditi ili odabrati URL za Googleov indeks. Uzroci uključuju blokiranje crawlanja, noindex direktivu, pogrešan canonical URL, HTTP pogrešku, nedovoljno interno povezivanje, duplicirani sadržaj i stranicu koju Google smatra nedovoljno vrijednom za indeksiranje.
Googlebot mora pronaći URL prije indeksiranja URL-a. Googlebot pronalazi URL-ove putem izvora, primjerice internih linkova, XML sitemap datoteke i linkova s drugih web stranica. Slabo povezana stranica može ostati neotkrivena ili se može rjeđe crawlati, posebno ako nema interne linkove s već poznatih stranica.
Indeksiranje URL-a zahtijeva dopušten pristup Googlebotu. robots.txt može ograničiti crawlanje određenih URL-ova ili direktorija. Server može vratiti statusne kodove, primjerice 403, 404, 429 ili 5xx. Google ne može normalno obraditi sadržaj kada Googlebot nema stabilan pristup URL-u.
Pristup URL-u ne znači automatsko uključivanje URL-a u indeks. Meta robots oznaka noindex ili HTTP X-Robots-Tag: noindex govori Googleu da URL ne uključi u indeks. URL može biti crawlabilan i istodobno ostati izvan indeksa kada Google pronađe noindex direktivu.
Canonical URL određuje preferiranu verziju sadržaja među sličnim URL-ovima. Google može izostaviti jedan URL iz indeksa kada drugi URL prepozna kao canonical verziju. Takva situacija pojavljuje se kod varijanti URL-ova, primjerice HTTP/HTTPS verzija, www/non-www verzija, URL-ova s parametrima i dupliciranih kategorija.
Kako ubrzati indeksiranje web stranice?
Indeksiranje web stranice može se ubrzati uklanjanjem prepreka za Googlebot, slanjem URL-a kroz Google Search Console, ažuriranjem XML sitemap datoteke, jačanjem internog povezivanja i objavljivanjem jedinstvenog sadržaja. Google prvo otkriva URL, zatim dohvaća stranicu, obrađuje sadržaj i odlučuje može li URL ući u Google indeks. Brže otkrivanje i lakše dohvaćanje povećavaju mogućnost ranijeg indeksiranja.
- Pošaljite URL kroz Google Search Console.
Google Search Console omogućuje provjeru pojedinačnog URL-a i zahtjev za indeksiranje. Zahtjev usmjerava Google prema novoj ili izmijenjenoj stranici. Slanje URL-a ne jamči indeksiranje. - Dodajte URL u XML sitemap.
XML sitemap povezuje web stranicu s njezinim indeksabilnim URL-ovima, primjerice stranicama usluga, kategorijama i člancima. Sitemap treba sadržavati kanonske URL-ove koji vraćaju HTTP status 200. - Povežite novu stranicu internim poveznicama.
Interne poveznice omogućuju Googlebotu otkrivanje URL-a preko već poznatih stranica. Nova stranica može dobiti poveznice sa stranica, primjerice početne stranice, relevantne kategorije i tematski povezanog članka. Važniji URL treba biti dostupan kroz kraću putanju interne povezanosti. - Provjerite robots.txt.
robots.txt kontrolira pristup crawlera određenim URL-ovima i direktorijima. Googlebot ne može normalno dohvatiti sadržaj za indeksiranje kada relevantno pravilo blokira crawling URL-a. - Provjerite meta robots oznaku.
Meta robots oznaka noindex govori Googleu da stranicu ne uključuje u indeks. Indeksabilna stranica ne smije sadržavati noindex, ako je cilj pojavljivanje URL-a u Google indeksu. - Postavite ispravan canonical URL.
Canonical oznaka određuje preferiranu verziju među sličnim URL-ovima. Self-referencing canonical povezuje indeksabilnu stranicu sa samom sobom. Google može odabrati drugi URL za indeksiranje, ako canonical pokazuje prema drugoj stranici. - Koristite HTTP status 200.
Indeksabilan URL treba vraćati uspješan HTTP odgovor 200 OK. Statusi, primjerice 404, 410 i određena preusmjeravanja, mijenjaju način na koji Google obrađuje URL. - Objavite jedinstven i sadržajno potpun sadržaj.
Google procjenjuje sadržaj stranice nakon dohvaćanja URL-a. Naslov, H1, tekst, slike, interne poveznice i strukturirani podaci trebaju opisivati isti glavni entitet i temu. Vrlo slične stranice povećavaju mogućnost da Google odabere samo jednu verziju. - Smanjite dubinu indeksiranja.
URL smješten nekoliko klikova od početne stranice Googlebot lakše pronalazi kroz internu strukturu. Važne stranice treba povezati iz relevantnih navigacijskih i sadržajnih čvorova. - Ažurirajte interne poveznice nakon objave.
Postojeće indeksirane stranice mogu prenijeti put otkrivanja prema novom URL-u. Anchor tekst treba opisivati ciljnu stranicu, primjerice SEO optimizacija, tehnička SEO optimizacija ili lokalni SEO, kada ciljna stranica obrađuje taj entitet. - Uklonite crawl i render probleme.
Googlebot mora moći dohvatiti ključne resurse, primjerice HTML, CSS i JavaScript potreban za prikaz glavnog sadržaja. Serverske pogreške, beskonačna preusmjeravanja i nedostupan sadržaj mogu usporiti obradu URL-a. - Poboljšajte crawl put prema važnim URL-ovima.
Interna arhitektura određuje odnose između stranica. Hub stranice mogu povezivati povezane podstranice, primjerice SEO optimizacija → tehnička SEO optimizacija → indeksiranje web stranice. Takav odnos daje Googlebotu jasan put prema novom URL-u.
Koliko traje indeksiranje web stranice?
Indeksiranje web stranice može trajati od nekoliko sati do nekoliko tjedana. Google često indeksira dostupnu i pravilno povezanu stranicu u roku od nekoliko dana. Točno vrijeme indeksiranja nije zajamčeno. Vrijeme se može produžiti, ako je stranica nova, slabo povezana ili rijetko crawled.
Vrijeme indeksiranja ovisi o otkrivanju URL-a i crawlanju stranice. Googlebot prvo otkriva URL preko izvora, primjerice interne poveznice, XML sitemap datoteke ili ranije poznate stranice. Googlebot zatim dohvaća sadržaj i procjenjuje može li URL ući u Googleov indeks.
Brže indeksiranje povezano je s lakšim otkrivanjem i dostupnošću stranice. Signali, primjerice interne poveznice, XML sitemap, ispravan HTTP status 200 i dostupnost Googlebotu, olakšavaju crawling. Crawling može kasniti, ako je URL duboko u strukturi web stranice, nema interne poveznice ili poslužitelj često vraća pogreške.
Indeksiranje može trajati dulje kod novih web stranica i novih URL-ova. Nova domena može imati nižu učestalost crawlanja jer Google još nema ustaljen obrazac ponovnog posjećivanja. Postojeća web stranica s često crawlanim stranicama može omogućiti brže otkrivanje novog URL-a.
Kako provjeriti je li web stranica indeksirana?
Ispod su koraci kako provjeriti je li web stranica indeksirana
Provjerite URL u Google Search Consoleu. Otvorite URL Inspection i unesite puni URL stranice. Google Search Console prikazuje nalazi li se URL u Googleovu indeksu.
Provjerite status indeksiranja. Status „URL is on Google” potvrđuje da je stranica indeksirana. Status „URL is not on Google” znači da URL trenutačno nije dio Googleova indeksa.
Provjerite razlog neindeksiranja. Google Search Console prikazuje razloge, primjerice noindex, blokiranje putem robots.txt, preusmjeravanje, dupliciranu stranicu ili otkriven URL koji još nije indeksiran.
Provjerite posljednje indeksiranje. URL Inspection prikazuje podatke o Googleovu zadnjem indeksiranju. Podaci uključuju datum zadnjeg crawlanja, dopuštenje za crawling i dopuštenje za indeksiranje.
Provjerite kanonski URL. Google Search Console prikazuje korisnički deklarirani canonical i canonical koji je odabrao Google. Drugi canonical može objasniti zašto određeni URL nije zasebno indeksiran.
Pokrenite Live Test. Live Test provjerava može li Google trenutačno pristupiti URL-u. Dostupnost URL-a za crawling ne potvrđuje indeksiranje, jer crawling i indeksiranje predstavljaju različite statuse.
Zatražite indeksiranje nakon izmjene. Opcija „Request Indexing” šalje URL Googleu na ponovno pregledavanje. Zahtjev ne jamči indeksiranje, ali URL ulazi u proces ponovnog crawlanja.
Što znači kada web stranica nije indeksirana?
Web stranica nije indeksirana kada njezin URL nije pohranjen u Googleovom indeksu i zato se ne može prikazati u rezultatima Google pretraživanja. Google može otkriti i indeksirati URL nakon što Googlebot pronađe stranicu, pristupi sadržaju i obradi sadržaj. URL ostaje izvan indeksa kada Google ne može pristupiti stranici, ne odabere URL za indeksiranje ili dobije signal koji sprječava indeksiranje.
Googleov indeks sadrži obrađene web stranice i njihove informacije. Web stranica izvan Googleovog indeksa nema indeksirani dokument koji Google može dohvatiti za relevantan upit. Google zato ne može rangirati tu stranicu u organskim rezultatima dok URL nije indeksiran.
Neindeksirana web stranica može imati različite statuse i uzroke, primjerice noindex, blokiranje putem robots.txt, preusmjeravanje, duplicirani URL, canonical prema drugom URL-u, HTTP pogrešku ili status „Crawled – currently not indexed”. Svaki uzrok opisuje drugi odnos između URL-a, Googlebota i Googleovog indeksa. Stranica može biti dostupna korisniku, ali ostati izvan Googleovog indeksa ako Google ne uključi URL u indeks.
Kako poslati web stranicu na indeksiranje?
Web stranicu šaljete na indeksiranje tako da URL prijavite Googleu putem alata URL Inspection u Google Search Consoleu i odaberete opciju „Request Indexing”. Google zatim dohvaća URL, provjerava dostupnost stranice, obrađuje sadržaj i odlučuje hoće li URL dodati ili ažurirati u Google indeksu. Slanje zahtjeva pokreće zahtjev za ponovno indeksiranje, ali ne jamči indeksiranje.
- Dodajte web stranicu u Google Search Console. Google Search Console povezuje verificiranu web lokaciju s vlasnikom ili ovlaštenim korisnikom. Verifikacija može koristiti metode, primjerice DNS zapis, HTML datoteku ili HTML oznaku.
- Otvorite URL Inspection. URL Inspection provjerava određeni URL i prikazuje njegov status u Google indeksu. Alat može pokazati informacije, primjerice je li URL indeksiran, kada je zadnji put indeksiran i postoje li prepreke za indeksiranje.
- Unesite puni URL stranice. Puni URL određuje točnu stranicu koju Google provjerava. Protokol, poddomena i putanja razlikuju URL-ove, primjerice https://example.com/seo/ i https://www.example.com/seo/.
- Provjerite dostupnost URL-a. Googlebot može indeksirati stranicu kada URL dopušta crawling i indeksiranje. Direktive, primjerice noindex, blokiranje u robots.txt i određene canonical postavke, mogu utjecati na obradu URL-a.
- Kliknite „Request Indexing”. Request Indexing šalje pojedinačni URL Googleu na ponovno dohvaćanje i obradu. Google može ponovno crawlati stranicu nakon zahtjeva, posebno ako je sadržaj nov ili izmijenjen.
- Pošaljite XML sitemap. XML sitemap daje Googleu popis URL-ova namijenjenih otkrivanju i indeksiranju. Sitemap je posebno koristan za skupine URL-ova, primjerice stranice usluga, kategorije, proizvode i članke.
- Povežite URL internim poveznicama. Interne poveznice povezuju novu stranicu s postojećim stranicama web lokacije. Googlebot lakše otkriva URL kada druge crawlable stranice upućuju na novi URL.
- Provjerite status indeksiranja. URL Inspection prikazuje status nakon što Google obradi URL. Ponovno slanje istog URL-a ne znači da će Google indeksirati stranicu brže.
Kako indeksiranje utječe na SEO optimizaciju?
Indeksiranje utječe na SEO optimizaciju tako što određuje može li Google pohraniti web stranicu u svoj indeks i koristiti je kao kandidata za prikazivanje u rezultatima pretraživanja. SEO optimizacija ne može ostvariti organsku vidljivost za URL koji nije indeksiran. Indeksirani URL može konkurirati za relevantne upite kada sadržaj, tehnička dostupnost i signali relevantnosti odgovaraju upitu korisnika.
Indeksirani URL ulazi u skup dokumenata dostupnih sustavu pretraživanja. Skup dokumenata sadrži informacije, primjerice naslov stranice, glavni sadržaj, interne poveznice, canonical signale i strukturirane podatke. Google koristi te informacije za povezivanje URL-a s entitetima, atributima i upitima. Povezivanje s upitima povećava mogućnost rangiranja kada indeksirana stranica jasno odgovara namjeri pretraživanja.
Mogućnost rangiranja ovisi o kvaliteti indeksiranih informacija. Indeksirane informacije daju Googleu signale, primjerice temu stranice, značenje naslova, odnose između entiteta i kontekst internih poveznica. Jasni signali povećavaju razumljivost dokumenta. Razumljivost dokumenta podržava relevantnost za ciljani upit kada sadržaj izravno opisuje traženi entitet i njegove atribute.
Relevantnost za ciljani upit može se smanjiti zbog problema s indeksiranjem. Problemi s indeksiranjem, primjerice noindex, pogrešan canonical, blokirani resursi, duplicirani URL-ovi i nedostupne stranice, mogu spriječiti uključivanje odgovarajućeg URL-a u indeks ili promijeniti URL koji Google smatra kanonskim. Kanonski URL tada postaje dokument kojem Google pripisuje glavne signale stranice.
Glavni SEO odnos zato glasi: indeksiranje omogućuje dostupnost dokumenta za rangiranje, dok SEO optimizacija povećava njegovu relevantnost i kvalitetu signala. Indeksiranje samo po sebi ne jamči visoku poziciju. Visoka pozicija postaje moguća kada indeksirani URL zadovoljava kriterije relevantnosti, kvalitete i drugih sustava rangiranja.
Koja je razlika između crawliranja i indeksiranja?
Crawliranje je proces kojim Googlebot otkriva i dohvaća web stranicu, dok je indeksiranje proces kojim Google analizira stranicu i može pohraniti njezine informacije u Googleov indeks. Google može crawlirati URL bez indeksiranja URL-a. Crawliranje potvrđuje da je Googlebot pristupio resursu. Indeksiranje određuje može li sadržaj postati dio Googleova indeksa.
Googlebot otkriva URL-ove putem izvora, primjerice internih poveznica, vanjskih poveznica i XML sitemap datoteka. Otkriveni URL Googlebot može dohvatiti i obraditi. Dohvaćanje ovisi o dostupnosti URL-a, HTTP odgovoru, pravilima za crawliranje i tehničkoj dostupnosti resursa.
Indeksiranje obrađuje crawlirani sadržaj i njegove signale, primjerice tekst, naslov stranice, canonical oznaku, poveznice i strukturirane podatke. Google procjenjuje reprezentativni URL kada pronađe duplikate ili vrlo slične stranice. URL može biti crawliran, ali ostati izvan indeksa, ako Google odabere drugi canonical URL ili utvrdi drugi razlog za neindeksiranje.
Zašto nova web stranica nije vidljiva na Googleu?
Nova web stranica nije vidljiva na Googleu kada Google još nije otkrio, crawlirao ili indeksirao njezin URL ili kada indeksiranje blokira tehnički signal. Objavljivanje stranice ne znači automatsko uključivanje u Googleov indeks. Google prvo otkriva URL, zatim ga crawla i obrađuje za moguće indeksiranje.
Tehnički signali mogu spriječiti indeksiranje, primjerice noindex, pogrešan canonical, HTTP pogreške i ograničen pristup Googlebotu. Robots.txt može spriječiti crawliranje URL-a. noindex može spriječiti uključivanje stranice u indeks kada Google može dohvatiti stranicu i pročitati tu direktivu.
Slabo otkrivanje URL-a može usporiti obradu nove stranice. Interne poveznice povezuju novi URL s postojećom strukturom web stranice. XML sitemap daje Googleu dodatni izvor URL-ova. Google Search Console može pokazati poznaje li Google URL i koji status indeksiranja Google prijavljuje.
Kako Google indeksira novu stranicu?
Google indeksira novu stranicu kroz slijed otkrivanja URL-a, crawliranja, renderiranja, analize sadržaja, canonicalizacije i odluke o indeksiranju. URL prvo postaje poznat Googleu. Googlebot zatim može zatražiti URL i preuzeti sadržaj koji poslužitelj vraća.
Crawlirani sadržaj prolazi obradu u kojoj Google analizira elemente, primjerice glavni tekst, <title>, slike, poveznice, canonical oznaku i strukturirane podatke. Renderiranje omogućuje obradu sadržaja koji ovisi o JavaScriptu. Analiza povezuje sadržaj URL-a s informacijama koje Google može koristiti u svojem indeksu.
Canonicalizacija određuje reprezentativni URL kada više URL-ova prikazuje isti ili vrlo sličan sadržaj. Odabrani canonical može biti indeksiran kada stranica zadovoljava uvjete za indeksiranje. Indeksirani URL tada može biti kandidat za prikaz u rezultatima pretraživanja, ali indeksiranje samo po sebi ne jamči prikaz za određeni upit.
Kako riješiti problem s indeksiranjem web stranice?
Problem s indeksiranjem rješava se utvrđivanjem statusa URL-a, uklanjanjem tehničke prepreke i omogućavanjem Googleu da ponovno obradi ispravan URL. Prvi korak je provjera konkretnog URL-a. Status pokazuje je li URL nepoznat, crawliran, blokiran, dupliciran ili isključen iz indeksa.
Tehničke probleme treba provjeravati prema uzroku, primjerice noindex, robots.txt blokadu, canonical oznaku, HTTP status, preusmjeravanje i dostupnost sadržaja. Indeksabilna stranica obično vraća odgovarajući uspješan HTTP odgovor i ne sadrži direktivu koja zabranjuje indeksiranje. Canonical treba upućivati na željeni URL kada je taj URL glavna verzija sadržaja.
Ponovno otkrivanje URL-a pomaže Googleu obraditi promjenu nakon uklanjanja problema. Interna poveznica može povezati URL s relevantnom postojećom stranicom. XML sitemap može sadržavati canonical URL. Zahtjev za indeksiranje kroz Google Search Console može potaknuti ponovno crawliranje, ali ne jamči indeksiranje.
Koji alati se koriste za provjeru indeksiranja?
Google Search Console je primarni Googleov alat za provjeru statusa indeksiranja pojedinačnih URL-ova i većih skupina stranica. URL Inspection prikazuje informacije o poznatom URL-u, indeksiranju, crawliranju i canonical URL-u. Page Indexing izvještaj prikazuje obrasce indeksiranih i neindeksiranih stranica.
Tehnički alati mogu provjeriti signale povezane s indeksiranjem, primjerice HTTP status, robots direktive, canonical oznake i interne poveznice. Alati za crawliranje web stranice mogu pronaći nedosljednosti na većem broju URL-ova. Server logovi mogu potvrditi pristupa li Googlebot određenom URL-u.
Provjera indeksiranja daje najtočniji rezultat kada se kombiniraju različiti izvori podataka. Google Search Console pokazuje Googleov prijavljeni status URL-a. Crawler pokazuje tehničku konfiguraciju web stranice. Server log pokazuje stvarne zahtjeve Googlebota prema poslužitelju.
Kako Google Search Console pomaže kod indeksiranja?
Google Search Console pomaže kod indeksiranja tako što prikazuje može li Google pronaći, dohvatiti i indeksirati URL web stranice. Google Search Console povezuje URL sa statusima indeksiranja, primjerice „Indexed”, „Crawled – currently not indexed” i „Discovered – currently not indexed”. Status pokazuje odnos između URL-a i Google indeksa.
Google Search Console prikazuje informacije o indeksiranju kroz URL Inspection i izvješća o indeksiranju stranica. URL Inspection prikazuje status URL-a, posljednje indeksiranje, dostupnost za Googlebot i dopuštenje za indeksiranje. Ti podaci pokazuju razlog zbog kojeg određeni URL jest ili nije u Google indeksu.
Vlasnik web stranice može poslati pojedinačni URL na ponovno indeksiranje nakon promjene sadržaja. Zahtjev za indeksiranje šalje URL Googleu na ponovnu obradu, ali ne jamči ulazak u indeks. Google indeksira URL nakon obrade ako URL zadovoljava uvjete za indeksiranje.
Može li web stranica biti crawlana, ali ne indeksirana?
Web stranica može biti crawlana, ali ne indeksirana jer crawling i indeksiranje predstavljaju različite procese. Googlebot može dohvatiti URL i analizirati njegov sadržaj bez dodavanja URL-a u Google indeks. Google Search Console takvo stanje može prikazati kao „Crawled – currently not indexed”.
Crawlani URL može ostati izvan indeksa zbog signala, primjerice noindex direktive, dupliciranog sadržaja, odabira drugog kanonskog URL-a ili procjene stranice nakon obrade. Googlebot je u tim slučajevima pristupio URL-u. Proces indeksiranja završava bez uključivanja tog URL-a u indeks.
Crawling potvrđuje pristup resursu, dok indeksiranje potvrđuje pohranu i obradu sadržaja za moguće prikazivanje u rezultatima pretraživanja. URL može prijeći iz crawlanog u indeksirani status nakon ponovne obrade ako Google odluči uključiti URL u indeks.
Što blokira indeksiranje web stranice?
Indeksiranje web stranice blokira noindex direktiva kada Googlebot može dohvatiti stranicu i pročitati tu direktivu. Problemi s pristupom i obradom, primjerice HTTP pogreške, autentifikacija i nedostupan poslužitelj, mogu spriječiti Google da dođe do sadržaja potrebnog za indeksiranje.
Blokade pristupa utječu na mogućnost Googlebota da obradi URL. Robots.txt može blokirati crawling URL-a, dok noindex izravno određuje da dostupna stranica ne bude indeksirana. Te dvije kontrole imaju različite predikate: robots.txt kontrolira crawling, a noindex kontrolira indeksiranje.
Status URL-a ovisi i o signalima kanonikalizacije. Google može indeksirati drugi URL umjesto pregledanog URL-a kada više URL-ova predstavlja isti ili vrlo sličan sadržaj. Canonical signal tada povezuje skup s preferiranim URL-om umjesto sa svakom kopijom zasebno.
Kako robots.txt utječe na indeksiranje?
Robots.txt utječe na indeksiranje tako što Googlebotu dopušta ili zabranjuje crawling određenih URL-ova. Disallow pravilo ograničava dohvaćanje sadržaja. Robots.txt nije izravna naredba za uklanjanje URL-a iz Google indeksa.
Blokirani URL može ostati poznat Googleu preko izvora, primjerice internih poveznica, vanjskih poveznica i prethodnog crawlanja. Google tada može znati da URL postoji bez pristupa njegovu aktualnom sadržaju. Zabrana crawlanja zato nije jednaka zabrani indeksiranja.
Za uklanjanje dostupne stranice iz indeksa koristi se direktiva namijenjena indeksiranju, primjerice noindex. Googlebot mora pristupiti stranici kako bi pročitao noindex, pa robots.txt ne smije istodobno spriječiti pristup toj direktivi ako je cilj obrada noindex oznake.
Kako noindex tag sprječava indeksiranje?
noindex sprječava indeksiranje tako što tražilici daje direktivu da određenu stranicu ne uključi u indeks. Direktiva se može poslati kroz robots meta tag ili HTTP zaglavlje X-Robots-Tag. Googlebot mora dohvatiti resurs kako bi pročitao direktivu.
Google obrađuje noindex nakon crawlanja URL-a. URL može zato biti crawlani resurs bez statusa indeksirane stranice. Ponovno crawling omogućuje Googleu da otkrije promjenu kada se noindex doda ili ukloni.
Robots.txt može spriječiti Googlebot da vidi noindex direktivu. Noindex djeluje nakon pristupa sadržaju, ako crawling nije blokiran. Odnos je zato precizan: robots.txt kontrolira pristup, Googlebot izvršava crawling, a noindex kontrolira dopuštenje za indeksiranje.
Kako sitemap pomaže indeksiranju web stranice?
Sitemap pomaže indeksiranju tako što Googleu daje strukturirani popis URL-ova koje vlasnik web stranice smatra važnima za crawling i indeksiranje. XML sitemap olakšava otkrivanje URL-ova, posebno URL-ova koji imaju malo internih poveznica ili su nedavno objavljeni. Sitemap ne jamči indeksiranje.
Googlebot koristi sitemap kao signal za otkrivanje URL-ova. Sitemap može sadržavati URL-ove, primjerice stranice usluga, članke i kategorije. Google zatim odlučuje koje će URL-ove crawlati i koje će nakon obrade uključiti u indeks.
Sitemap povećava jasnoću strukture URL-ova za crawling kada sadrži kanonske i indeksabilne stranice. URL iz sitemapa može ostati neindeksiran ako Google nakon crawlanja odabere drugi canonical URL, pronađe noindex ili odluči ne uključiti URL u indeks. Sitemap pomaže otkrivanju i obradi URL-a, ali konačnu odluku o indeksiranju donosi Google.
Kako popraviti “Crawled – currently not indexed”?
“Crawled – currently not indexed” popravlja se povećanjem vrijednosti stranice za indeksiranje i uklanjanjem signala koji Googleu pokazuju da URL nije dovoljno koristan ili jedinstven. Google je već crawlao URL, ali ga nije uključio u indeks. Prioritet je provjeriti sadržaj, kanonski URL, interne poveznice, HTTP status i sličnost s drugim stranicama.
Vrijednost stranice za indeksiranje raste kada sadržaj jasno odgovara glavnom upitu i pokriva povezane atribute. Relevantni atributi uključuju entitete, podteme, činjenice, odnose i odgovore na povezane upite. Slab sadržaj, primjerice nekoliko generičkih odlomaka, ponovljeni opisi ili gotovo identične lokacijske stranice, može smanjiti razlog za indeksiranje URL-a.
Interna povezanost prenosi kontekst i važnost prema crawlanom URL-u. Dodajte interne poveznice s relevantnih stranica koristeći opisni anchor tekst. Provjerite canonical oznaku, status 200 OK, noindex, robots pravila i XML sitemap. Zatražite ponovno indeksiranje nakon poboljšanja stranice, ako URL predstavlja zaseban i koristan rezultat.
Kako popraviti “Discovered – currently not indexed”?
“Discovered – currently not indexed” popravlja se poboljšanjem dostupnosti, interne povezanosti i prioriteta URL-a za crawling. Google zna da URL postoji, ali ga još nije crawlao. Problem je zato prvenstveno povezan s otkrivanjem, crawl prioritetom i tehničkom dostupnošću URL-a.
Crawl prioritet raste kada važne stranice imaju jasne interne poveznice i kratku udaljenost od početne stranice. Interni izvori, primjerice navigacija, kategorije, hub stranice i povezani članci, mogu povezati novi URL s postojećom strukturom web stranice. XML sitemap dodatno navodi URL i datum zadnje izmjene kada je podatak točan.
Tehnička dostupnost omogućuje Googlebotu učinkovito dohvaćanje URL-ova. Provjerite vrijeme odgovora servera, preusmjeravanja, robots.txt, statusne kodove i nepotrebne parametarske URL-ove. Broj URL-ova bez vrijednosti smanjuje se uklanjanjem duplikata, beskonačnih kombinacija filtera i nepotrebnih arhiva, ako takvi URL-ovi troše crawling resurse.
Kako interna povezanost pomaže indeksiranju?
Interna povezanost pomaže indeksiranju tako što Googlebotu omogućuje otkrivanje URL-a i prenosi informacije o njegovoj temi, odnosima i relativnoj važnosti. Interna poveznica povezuje izvornu stranicu s ciljnom stranicom. Anchor tekst opisuje odnos između dva dokumenta.
Relevantne interne poveznice stvaraju jasne semantičke odnose između povezanih stranica. Poveznice mogu dolaziti iz elemenata, primjerice glavnog sadržaja, kategorija, breadcrumb navigacije i tematskih hub stranica. Stranica dobiva jači kontekst kada poveznice dolaze sa sadržajno bliskih URL-ova.
Dubina klika utječe na dostupnost stranice tijekom crawlanja. Važne stranice postavite bliže glavnim stranicama web sjedišta. Interna povezanost posebno pomaže novom ili slabo povezanom URL-u, ako Googlebot trenutačno ima malo putova kojima može doći do tog URL-a.
Kako kvaliteta sadržaja utječe na indeksiranje?
Kvaliteta sadržaja utječe na indeksiranje jer Google može odabrati indeksirati URL koji pruža dovoljno jedinstvenih, relevantnih i korisnih informacija za određeni upit ili temu. Kvalitetan sadržaj jasno opisuje glavni entitet. Sadržaj povezuje entitet s njegovim atributima, vrijednostima i relevantnim odnosima.
Jedinstvena informacijska vrijednost razlikuje stranicu od drugih URL-ova iste web stranice. Korisne informacije, primjerice cijene, dimenzije, postupci, uvjeti, lokacije i konkretni primjeri, daju stranici specifične činjenice kada su relevantne za temu. Prepisivanje istih tvrdnji drugim riječima ne stvara jednaku informacijsku vrijednost.
Tematska potpunost pokriva atribute koji izravno pripadaju glavnom entitetu bez udaljavanja od namjere stranice. Stranica o indeksiranju može obraditi crawling, Googlebot, canonical, noindex, XML sitemap i interne poveznice. Takvi povezani pojmovi održavaju malu semantičku udaljenost od glavnog entiteta indeksiranje web stranice.
Kako tehnička SEO optimizacija pomaže indeksiranju?
Tehnička SEO optimizacija pomaže indeksiranju tako što tražilicama omogućuje pristup, crawling, interpretaciju i odabir ispravne verzije URL-a za indeks. Tehnički signali određuju može li Googlebot dohvatiti stranicu i koji URL predstavlja kanonsku verziju sadržaja.
Indeksabilnost ovisi o tehničkim elementima, primjerice HTTP statusu, robots.txt pravilima, meta robots oznaci, canonical oznaci i preusmjeravanjima. Indeksabilna stranica u pravilu vraća 200 OK i nema direktivu koja zabranjuje indeksiranje. Canonical treba pokazivati prema preferiranom URL-u kada postoje duplikati ili vrlo slične verzije.
Crawl učinkovitost raste kada arhitektura web stranice ograničava nepotrebne URL-ove i jasno povezuje važne URL-ove. XML sitemap, interna struktura i konzistentni URL-ovi pomažu Googlebotu pronaći relevantne stranice. Tehničku pogrešku popravite prije zahtjeva za ponovno indeksiranje, ako pogreška sprječava crawling ili indeksabilnost.
Kako indeksirati WordPress web stranicu?
WordPress web stranica indeksira se tako da tražilicama omogućite crawling, uklonite noindex direktive, povežete važne URL-ove internim poveznicama i uključite indeksabilne URL-ove u XML sitemap. WordPress postavka koja odvraća tražilice od indeksiranja ne smije biti aktivna na javnoj produkcijskoj stranici. Važne stranice trebaju vraćati status 200 OK.
WordPress indeksabilnost provjerava se kroz robots postavke, canonical oznake, XML sitemap i postavke SEO dodatka. SEO dodaci mogu upravljati elementima, primjerice meta robots direktivama, canonical URL-ovima i sitemapovima. Stranice, objave, kategorije i druge vrste sadržaja indeksirajte kada predstavljaju zasebnu vrijednost za korisnika i pretraživanje.
Google lakše pronalazi WordPress URL kada URL postoji u logičnoj arhitekturi i prima relevantne interne poveznice. Povežite važne stranice iz elemenata, primjerice glavnog sadržaja, kategorija, navigacije i breadcrumb strukture. Pošaljite XML sitemap kroz Google Search Console i zatražite indeksiranje važnog URL-a nakon objave ili značajne izmjene.
